Você acabou de chegar na empresa e tornou-se responsável por um sistema antigo, com mais de 20 anos de existência, e todas as pessoas mais “antigas” já saíram do projeto. Você tem um problema em produção e precisa resolver urgentemente. “Meu Deus, onde está implementada a parte que confirma o crédito do usuário de Piraporinha do Sul, durante solstícios de ano bissexto?” é o que você se pergunta. Abrir o Claude? Ok, é uma opção. Mas até ele ler toda a base de código, ou estoura seus tokens, ou ele alucina com tanta coisa pra olhar. E agora?
O que é RAG?
Existem duas coisas que me aborrecem em todo esse hype de Inteligência Artificial. A primeira é essa “mania” de fazer as coisas parecerem mais complexas do que são (para vender curso?). A segunda é a reciclagem de ideias antigas apenas mudando nome para alguma coisa em inglês. RAG especificamente sofre dois dois casos. Um pouco menos do segundo, mas absolutamente muito do primeiro. Então, deixa eu “mastigar” um pouquinho esse conceito.
RAG é mais simples do que parece
Nas minhas aulas de Hebraico (sim, eu estudei hebraico), eu aprendi que entender a etimologia e o significado puro das palavras pode te trazer muito conhecimento. RAG, por exemplo, é um acrônimo para as palavras: Retrieval-Augmented Generation.
Retrieval costuma ser traduzido como “recuperação”, mas eu entendo retrieve mais como “obter através de uma busca”. Quando você escreve um SQL, você está fazendo um retrieval, sacou? Já o hífen ali está para dizer que há uma relação entre “aumentado” (no sentido de potencializar, dar mais poder para) e a busca.
Ou seja: RAG nada mais é do que Aumentar o poder de geração (de texto de uma LLM) através do resultado de uma busca. Isso quer dizer que ao invés da LLM gerar o output, carregando toda uma base de arquivos no seu contexto, ela faz uma pesquisa que, ao mesmo tempo que reduz a quantidade de informação que ela precisa carregar no contexto, também aumenta a qualidade dessa mesma informação através de uma pesquisa semântica.
“RAG” não é novo
Se você não sabe o que é uma pesquisa semântica, dê uma olhada nesse texto aqui para entender melhor. Mas TLDR: É a capacidade de encontrar um texto utilizando palavras diferentes, mas com o mesmo valor de compreensão. É como você digitar campo contains 'me traga os filmes em que o Matt Damon está encontrando dificuldades de voltar para casa' e na listagem aparecem os filmes “Perdido em Marte”, “Ilíada”, “O resgate do soldado Ryan”.
A parte principal de uma RAG, na minha percepção, não é a LLM em si. É a pesquisa semântica. Verdade seja dita, as novas tecnologias aumentaram consideravelmente a qualidade dessas pesquisas. No entanto, transformar texto em vetor para viabilizar pesquisa semântica é matéria de estudos desde os anos 1970! Então não podemos dizer que é uma “novidade da I.A.”. A gente já fazia isso em Delphi há um tempão!
Aliás, aqui vale ressaltar um ponto importante, e que pode ser tema de confusão pra muita gente. Para transformar o seu texto em vetor, você vai precisar de um modelo. Mas esse modelo não é um modelo conversacional. Ele é especialista em vetorizar texto. Você envia para ele um texto (Lorem Ipsum Dolor sit amet…) e ele transforma isso em um vetor multidimensional ([123, 34622, 623462, 734, …]).
Resume pra mim?
Bom, resumindo: Uma RAG é uma forma de aumentar o poder de geração de texto de uma LLM, fornecendo para ela menos texto, mas de maior qualidade para a construção do seu contexto. E isso inclui uma série de transformações. Um verdadeiro pipeline que veremos à seguir.
O pipeline de uma RAG
Preparando o texto
Nem todo tipo de dado é amigável para uma LLM. Texto é o tipo de informação preferido dela. Logo, se você adiciona um PDF ao seu chat, você corre o risco de só piorar a situação. Isso porque o PDF vai conter uma série de dados que não fazem o menor sentido para a LLM (pra quê ela vai querer saber o encoding ou o hash de assinatura do arquivo?). Então a primeira etapa é transformar o conteúdo em texto legível.
Código fonte já é texto – as vezes questionamos a legibilidade dele, mas isso é outra história. Então essa primeira etapa está fácil. Não podemos dizer o mesmo da segunda.
Dividindo os chunks
Nos anos 2000, o humorista Paulo Silvino tinha um personagem que falava impropérios, ou qualquer coisa assustadora. Tomava um gole de whisky enquanto seu interlocutor expressava seu espanto, para só depois completar a frase com algo que mudava completamente o significado. Seus pais com certeza lembram do bordão “não espera eu molhar o bico”.
https://www.instagram.com/reels/DXediKTEqK6
Chunk é pedaço de um todo que foi seccionado, partido, quebrado, dividido. É, amigo e amiga da tecnologia, você não vai mandar para o modelo de vetores a Ilíada de Homero inteira e resumir tudo isso em um array de 1024 posições. Você tem que quebrar em pedaços menores. Parece simples – e é – mas tem uma pegadinha.
O problema é que se você fizer chunks grandes demais, ou pequenos demais, você corre o risco de perder – ou até mesmo alterar – a semântica do seu texto. Você vai fazer igualzinho o Paulo Silvino do Zorra Total. E com isso, você acaba diminuindo o poder de geração ao oferecer texto de baixa similaridade para a LLM.
Para código fonte, nós poderíamos definir o quê como chunk? Um módulo? Uma classe? Um método? Vai depender muito, eu acredito, da qualidade de código que você tem hoje. Um módulo eu acho grande demais. Mas se você tem boa segmentação entre classes (O “S” e o “I” do SOLID), talvez você possa usar classes. Mas pouquíssimas vezes eu pude ver uma base de código assim. Então eu utilizaria mesmo um método como critério de chunks.
Árvore sintática abstrata (AST)
Falando especificamente de código: A gente é obrigado a escrever muito boilerplate. Mesmo linguagens, que se dizem menos verbosas, tem conteúdo que pouco – ou nada – agrega para o entendimento da regra de negócio aplicada. Por isso, simplesmente vetorizar o código não ajudaria muito.
Para entendermos os fluxos que um código segue, a estratégia geral é construir uma AST – Abstract Sintax Tree. Ela fornece uma abstração enxuta do que o código está fazendo e quais fluxos ele segue. Transformar isso em texto seria um esforço puramente mecânico, sem exigir auxilio de modelos de conversacionais.
Outra vantagem que a AST nos proporcional é criar um grafo de dependências do código analisado. Você consegue saber quem chama o método e quais outros métodos ele chama. Montar um grafo das chamadas – para que a LLM procure pelos efeitos colaterais – faz parte do enriquecimento de contexto.
Estabelecendo um protocolo ou representação intermediária
Após vetorizar a primeira base de código, você não vai querer parar mais. E além disso, qualquer base de código é composta por outros léxicos informatas (gastei, hein?). Um código C#, por exemplo, vai ter elementos em json (o appsettings, por exemplo); em XML (os resource files); em YAML (os manifestos de deployment e/ou docker compose) e por aí vai. Você não vai querer criar um indexador para cada um deles (calma, já te digo o que é um indexador). Por isso é legal estabelecer um padrão comum.
Já existem uma série de maneiras de representar algoritmos e base de código, quer de maneira textual ou através de grafos. Você vai preferir aquela que é textual, mas que também não gere um texto enorme e pobre de sentido. Para chegar nesse meio termo, eu acabei utilizando um modelo simplificado. Um objeto JSON que traz detalhes sobre um elemento (seja ele um método ou uma classe ou um enum…).
{
    "schemaVersion": "1.1",
    "id": "sha256:40c998ee20c9ae96204f9d5c705f118f6dabffbc3355bcbbb14a31a7c51f7e3a",
    "kind": "type",
    "language": "csharp",
    "project": "CodeRag.Api",
    "symbol": {
        "name": "CodeQueryTypeNameFilterRequest",
        "qualifiedName": "CodeRag.Api.Contracts.CodeQueryTypeNameFilterRequest",
        "canonicalName": "CodeRag.Api.Contracts.CodeQueryTypeNameFilterRequest",
        "container": "CodeRag.Api.Contracts"
    },
    "source": {
        "path": "src/CodeRag.Api/Contracts/CodeQueryTypeNameFilterRequest.cs",
        "startLine": 14,
        "startColumn": 1,
        "endLine": 18,
        "endColumn": 44,
        "hash": "sha256:bcc83cbc12e48c4a606b16e2f7e14d5df0d62a7de1e65109ec7c57abd747816f"
    },
    "documentation": {
        "format": "xml-doc",
        "source": "declared",
        "summary": "Optional filter narrowing results to code documents matching a typeName condition.",
        "parameters": [
            {
                "name": "Operator",
                "description": "Comparison operator to apply."
            },
            {
                "name": "Value",
                "description": "Value to compare typeName against. Must not be empty or blank. When the operator is Contains or NotContains, * acts as a wildcard matching any sequence of characters (e.g. *Controller matches values ending with \u0022Controller\u0022); a value with no * is matched exactly (case-insensitively). Ignored for other operators."
            }
        ]
    },
    "relations": [
        {
            "kind": "implements",
            "target": {
                "symbol": "System.IEquatable\u003CCodeRag.Api.Contracts.CodeQueryTypeNameFilterRequest\u003E"
            },
            "resolution": {
                "status": "external",
                "origin": "framework"
            }
        },
        {
            "kind": "overrides",
            "target": {
                "symbol": "System.Object.ToString()"
            },
            "resolution": {
                "status": "external",
                "origin": "framework"
            }
        },
        {
            "kind": "overrides",
            "target": {
                "symbol": "System.Object.GetHashCode()"
            },
            "resolution": {
                "status": "external",
                "origin": "framework"
            }
        },
        {
            "kind": "overrides",
            "target": {
                "symbol": "System.Object.Equals(System.Object)"
            },
            "resolution": {
                "status": "external",
                "origin": "framework"
            }
        }
    ],
    "type": {
        "typeKind": "record",
        "accessibility": "public",
        "modifiers": [
            "sealed"
        ]
    },
    "embeddingText": "Entity: type\nQualified name: CodeRag.Api.Contracts.CodeQueryTypeNameFilterRequest\nContainer: CodeRag.Api.Contracts\nDocumentation: Optional filter narrowing results to code documents matching a typeName condition.",
    "embeddingTextStrategy": "semantic-v1",
    "embeddingTextHash": "sha256:f4f439a75fec8664a9057a7e5ad89df81864a4de7815258a83490382fda0a1c4"
}
Acima segue um output real daquilo que eu chamei de Code Inteligent Intermediate Representation. Todas as informações vem através do próprio Roslyn. Nada até esse ponto é criado à partir de modelos (o que eu chamo de “gerado mecanicamente”). Repare que eu tenho um texto “mecanicamente” gerado em embeddingText, incluindo até o XML Docs do método. Estamos dando um bom uso aos comentários!.
Apesar das peculiaridades de C# presentes, nada impede que você tenha um programa Java, que gere um arquivo no mesmo schema, porém à partir de código Java. E fazer o mesmo com Javascript, com Python, com COBOL…
Indexação
O processo de indexação nada mais é do que transformar o seu código em um vetor. Mas por que transformar em um vetor? Agora vem a parte da teoria (não se assuste, eu não consigo ir tão à fundo ao ponto de desesperar alguém):
Transformar palavras em vetores
Tente imaginar um plano cartesiano de duas dimensões x e y. Neste plano cartesiano temos plotadas as coordenadas: 10,1; 9,2; 3,10 e 2,8.
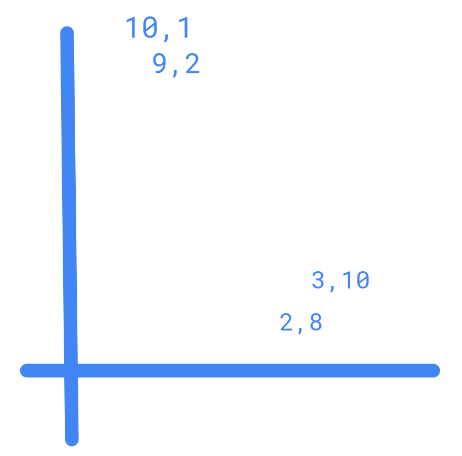
Visualmente é fácil perceber que as coordenadas 10,1 e 9,2 estão bastante próximas. Mas existe alguma forma de medir isso matematicamente? Sim! Uma das formas é medir o ângulo formado entre as palavras se traçarmos uma linha desde a coordenada 0,0 até cada das coordenadas. Quanto menor o ângulo, mais próximas as coordenadas estão uma das outras.
Agora assuma que nós conseguimos colocar palavras nesse gráfico. E nós colocamos as palavras de tal forma que aquelas que tem significado próximo fiquem igualmente próximas uma das outras. Assim as palavras gato e cachorro, poderiam ficar no canto superior central do gráfico. Enquanto carro e caminhão ficariam mais próximas do final do eixo x, próximo de 0 no eixo y.
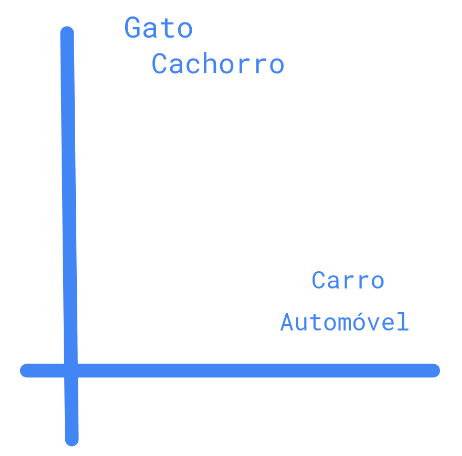
Se analisar os gráficos descritos, vai perceber que há uma similaridade (proposital nesse caso) entre o gráfico numérico e esse gráfico de palavras. E uma vez que esteja estabelecido que o posicionamento das palavras corresponde a sua proximidade lexical, vetorizar as palavras nos permite perceber a proximidade entre elas. Se você quiser mais detalhes sobre como isso é possível, eu recomendo a leitura desse artigo da Brains sobre embedding text.
Modelos de embedding
Agora que você sabe que vetores são seus amigos, você deve estar se perguntando qual seria o critério para atribuir um valor qualquer a uma palavra, ou conjunto de palavras. Considere, também, o cenário em que você precisa atribuir o posicionamento no gráfico para texto em inglês e em português também. Te adianto que 2 dimensões é muito pouco para representar a riqueza de palavras que temos.
É aqui que modelos de embedding entram em cena. Eles não foram feitos para conversar com você, mas para te devolver vetores data uma entrada. Caso você envie este parágrafo inteiro para um modelo de embedding, ao invés de dizer “Você está certo”, ele vai te devolver um array de números com várias dimensões. O modelo BGE-M3, por exemplo, trabalha com 1024 dimensões. E pode rodar tranquilamente na sua RTX 3060 12gb. Você pode usar Ollama, já que é um modelo de pesos abertos.
Indexando o CIIR
Agora que você manja tudo de embedding e vetorização, agora é hora de voltarmos para o nosso documento. O CIIR possui várias propriedades. Contudo, a melhor candidata para indexação é a embeddingText.
Esta propriedade possui não apenas detalhes de código, mas também parte do grafo de chamadas de métodos, além dos comentários XML, que enriquecem ainda mais o conteúdo (se bem escritos). O resto do objeto CIIR não é de se jogar fora. Ele pode enriquecer a resposta, permitindo que uma pessoa (ou LLM) seja capaz de explorar novos arquivos e conteúdos nessa árvore, descendo o grafo de execuções, por exemplo.
Agora que está tudo no banco de dados, acabou?
Recuperando as informações em dois tempos
Não basta ter os dados se você não conseguir recuperá-los. Mas tem dois detalhes importantes:
Vetorizar a pergunta com o mesmo modelo
A ideia da pesquisa semântica é calcular a distância entre dois textos. Um deles sabemos que é o código. E o outro qual é? É a pergunta!
A query que você vai submeter ao banco precisa, também, ser indexada. Do contrário, não conseguimos calcular o quão longe ela está do texto indexado – no caso, nosso código fonte. E como você já deve estar chegando à conclusão: Sim. Você vai ter que usar o mesmo modelo que usou para vetorizar o código. Do contrário, você pode ter respostas inválidas.
Com tudo isso resolvido, você só precisa de um comando SQL:
                 , ROUND((1 - (cd.embedding <=> @Embedding))::numeric, 10)::float8 AS Similarity
            FROM tabela cd
            WHERE ...
            ORDER BY cd.embedding <=> @Embedding
            LIMIT @Limit
No Where você pode colocar qualquer filtro que quiser, porém o truque está no order by. Percebe ali o operador <=>? É possível que você nunca tenha visto ele antes. Ele calcula a distância entre cossenos, ou em outras palavras, ele calcula a proximidade lexical entre o vetor armazenado no banco e o vetor da pergunta feita ao banco de dados. Se não fosse pelo modelo de embeddings, nenhum token teria sido gasto nessa operação.
Mas porque no order by?
O número calculado pela distância de cossenos vai variar de 0 até 2, onde:
- 0: Vetores idênticos
- 1: Vetores ortogonais (o famoso “nada a ver, irmão)
- 2: Vetores em direções diferentes
Para mostrar a similaridade entre cossenos, nós fazemos 1 – (distância de cossenos). Geralmente você vai fazer isso na definição do result set do select para mostrar a similaridade que é diferente da distância entre cossenos.
| Similaridade | Distancia | |
| Idênticos | 1 | 0 |
| Ortogonais/Desalinhados | 0 | 1 |
| Anti-alinhamento perfeito | -1 | 2 |
Aqui você já tem um bom resultado. Mas ainda é possível melhorar.
Reranking
Após selecionar algumas respostas, ainda é possível fazer um reranking do resultado. Basicamente, você agora submete pergunta + valores encontrados a um modelo cross-encoder. Esse modelo reavalia a correspondência entre pergunta e resposta, atribuindo um valor mais próximo do real da similaridade. Esse aí já foi demais pra mim. Se souber explicar a matemática por trás deles, me liga 🙂
Se por exemplo você pergunta “Onde fica a autorização de pagamento?” A pesquisa pode te retornar a classe exata onde isso é feito, bem como o controller de autorização da API. Como você pode imaginar, algo como PaymentKeycloakAuthorizer faria muito sentido entrar como resultado. O cross-encoder vai garantir que essa classe tenha a menor pontuação.
Chegamos ao fim? Ainda não, mas está próximo.
Como tornar isso acessível à LLM?
A resposta clássica e certeira é: Depende.
Você está construindo um chat de atendimento ao usuário, que utiliza uma integração com LLM? Talvez faça sentido você sempre enriquecer a pergunta do usuário com dados fornecidos pela sua busca semântica. Toda essa operação fica invisível pra quem está chamando.
Agora se você gostaria de utilizar essa pipeline em um harness, ou na tua IDE… Talvez construir um MCP seja mais interessante. Um MCP, ao lado de uma skill podem ser a solução para garantir que “onde está aquela função que processa a folha de pagamento em noites de luar” irá retornar um resultado relevante. O ponto de atenção principal é documentar bem o MCP. A sua LLM irá ler essas instruções e saber como utilizar a sua RAG.
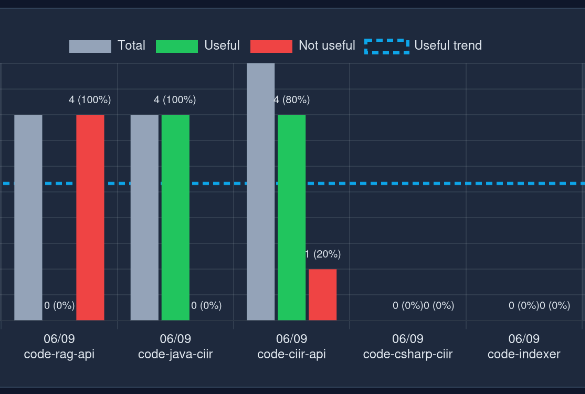
Eu inclusive adicionei uma instrução para que a LLM me dê feedback se o retorno da RAG foi útil ou não. Assim, consigo medir a efetividade do esforço:
Essa é a hora que você me pergunta: Tá, mas como eu implemento isso?
Recapitulando
A pipeline basicamente é:
- Transforme o seu texto em um padrão comum (ciir, no nosso caso);
- Indexe o ciir, transformando-o em um vetor e salvando em um banco de dados;
- Crie uma interface que permite humanos ou IA executarem pesquisas nessa base de dados.
Como implementar? Esse é um papo para um próximo post.